AI 기초 다지기 - 4편 AI 는 어떻게 말을 하나
AI 기초 다지기 · 4 / 10편
© 2026 crazy4eu (cwkim83) · 강좌 자료 CC BY-NC-ND 4.0 — 맨 아래 「저작권 · 라이선스」
단계 번호는 영상 왼쪽 위 장면 이름과 같고, "영상 시각"은 편집본 기준입니다. 모르는 말은 「📖 어려운 말 사전」에서 찾아보세요.
이전 편: AI 기초 다지기 - 3편 작업 저장과 공유 · 다음 편: AI 기초 다지기 - 5편 내 PC 에서 도는 AI · 처음으로: AI 기초 다지기 — 산초 강좌 전에 보는 10편
핵심 요약
| 항목 | 내용 |
|---|---|
| 이 편의 목표 | 이 편이 끝나면 LLM 이 '다음 말을 맞히는 거대한 예측기'라는 것, 오퍼스·소넷·하이쿠가 크기와 성격이 다른 모델이라는 것을 설명할 수 있습니다. 토큰(글의 조각)과 문맥(한 번에 볼 수 있는 범위), 프롬프트(부탁의 글)의 뜻을 알고, AI 가 모르는 것도 지어낼 수 있으니(환각) 중요한 내용은 출처를 확인하는 습관을 갖게 됩니다. |
| 배우는 말 | LLM · 모델 · 토큰 · 프롬프트 · 환각 |
| 길이 | 5:26 (실제 화면 시연 장면 2개) |
| 다음 편 | 다음 5편 · 내 PC 에서 도는 AI — 로컬 LLM |
4편 · AI 는 어떻게 말을 하나
0단계 · 여는 말 (영상 0:05)
안녕하세요, 파이스입니다. AI 기초 다지기, 4편입니다. 산초 강좌에서는 소넷으로 만들고 오퍼스로 검증한다는 말이 계속 나왔습니다. 오늘은 AI가 어떻게 말을 하는지, 모델마다 무엇이 다른지 알아봅니다. 토큰과 프롬프트, 그리고 AI가 가끔 지어내는 이유까지 다룹니다.
1단계 · LLM — 다음 말 예측기 (영상 0:27)
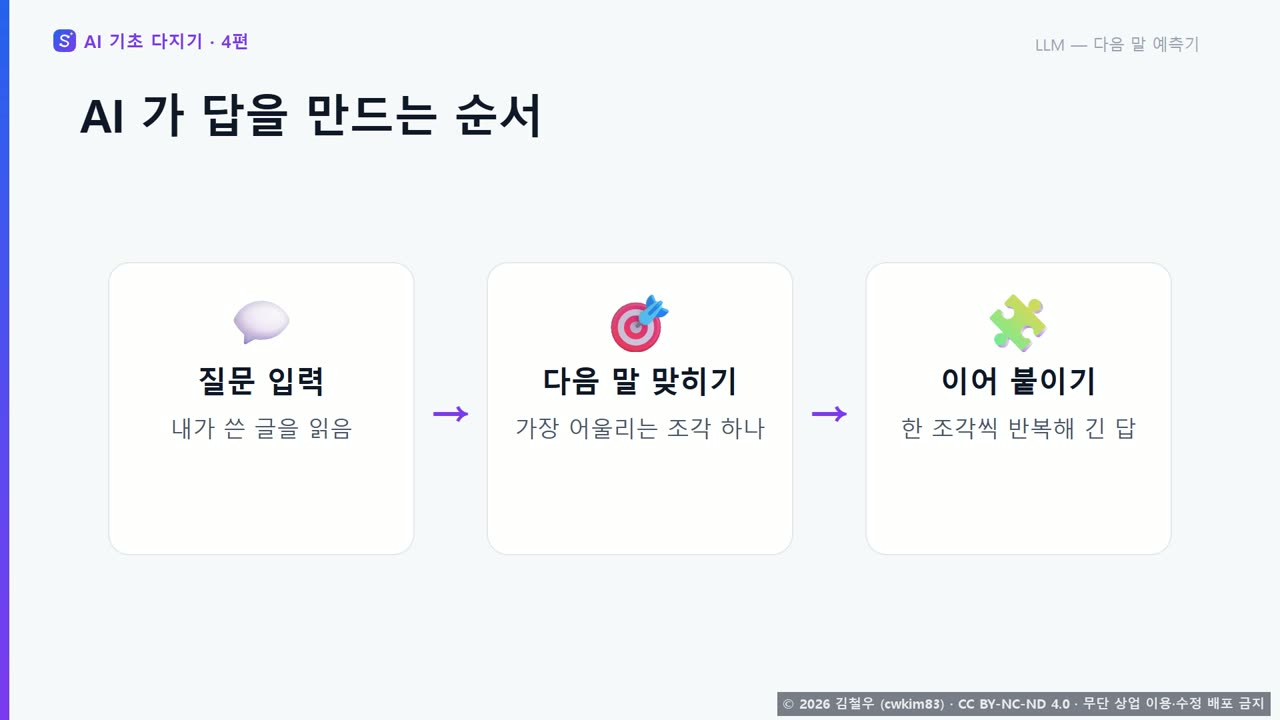
먼저 LLM입니다. LLM은 아주 많은 글을 읽고 배운, 거대한 글 예측기예요. 휴대폰 자동완성을 떠올려 보세요. 안녕 다음에 하세요를 추천해 주죠. LLM은 그 자동완성이 엄청나게 똑똑해진 것으로, 다음에 올 말을 하나씩 맞힙니다. 그렇게 한 조각씩 이어 붙이면 긴 답이 만들어져요. Claude도 LLM의 하나입니다. 사람처럼 생각한다기보다, 다음 말을 맞히는 계산을 쉬지 않고 반복하는 거예요.
2단계 · 모델 — 오퍼스 · 소넷 · 하이쿠 (영상 0:58)
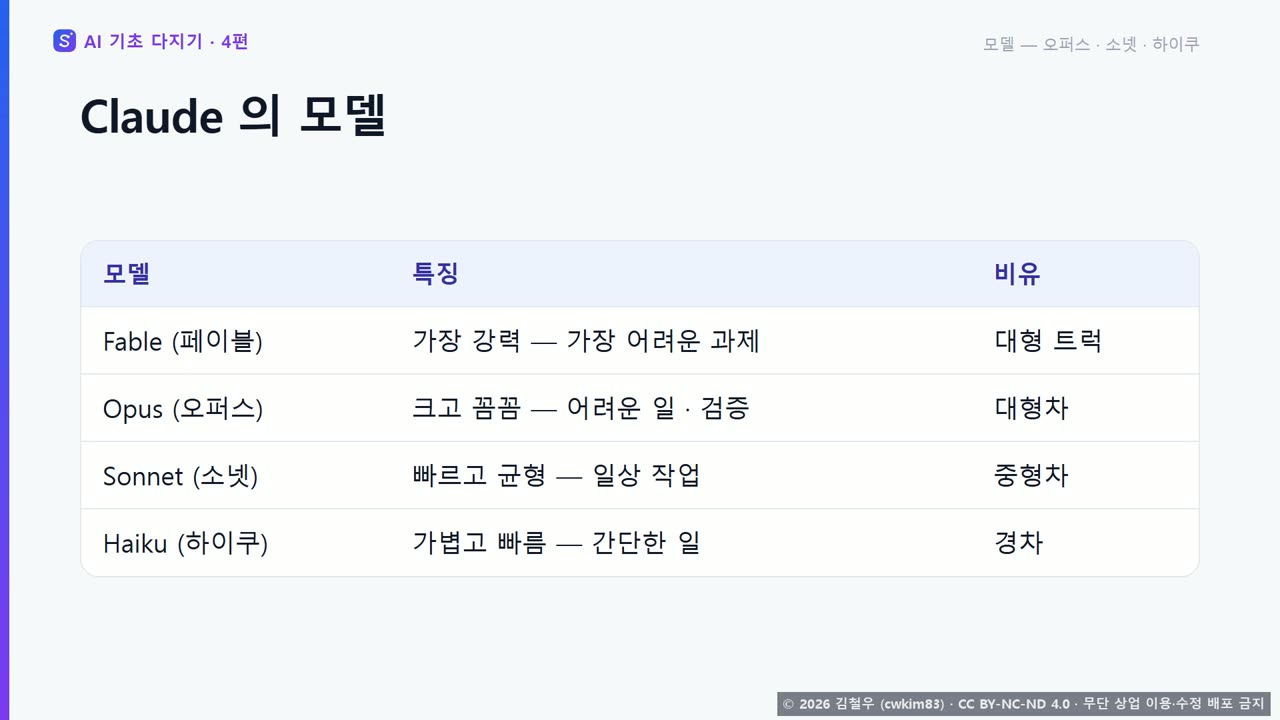
Claude라는 이름 아래에도 크기가 다른 모델이 여럿 있습니다. 모델은 AI의 한 종류를 뜻해요. Opus는 크고 꼼꼼한 모델입니다. 어려운 일을 맡기거나 검증할 때 씁니다. Sonnet은 빠르고 균형이 좋아서, 일상 작업의 주력이에요. Haiku는 가볍고 아주 빠르지만, 어려운 문제에서는 덜 꼼꼼할 수 있습니다. 목록 맨 위에는 가장 어려운 과제를 위한 Fable 이라는 모델도 있어요. 이름 뒤의 5.5 같은 숫자는, 몇 번째 판인지 알려 주는 번호예요.
3단계 · 토큰과 문맥 (영상 1:33)
AI는 글을 글자 대신 토큰이라는 조각으로 읽습니다. 레고 블록처럼 잘게 쪼갠 단위예요. 한국어는 같은 뜻이어도 영어보다 조각이 더 많이 나오는 편입니다. AI가 한 번에 눈앞에 펼쳐 놓고 볼 수 있는 양에는 한계가 있고, 이 범위를 문맥이라고 해요. 책상 크기와 같아서, 대화가 길어져 책상이 가득 차면 앞부분이 흐려집니다. 산초 강좌에서 편마다 새 세션을 연 이유가 바로 이것입니다. 참고로 산초 4편과 9편에 나온 토큰은 비밀번호 같은 열쇠예요. 이름만 같은 다른 말입니다.
4단계 · 프롬프트 (영상 2:11)
AI에게 하는 부탁의 글을 프롬프트라고 합니다. 산초 강좌의 요청문이 모두 프롬프트였어요. 같은 모델이라도 부탁을 어떻게 쓰느냐에 따라 답의 품질이 크게 달라집니다. 신입사원에게 일을 맡길 때처럼, 무엇을 어떤 조건으로 어떤 모양으로 달라고 말해 주세요. 그냥 정리해 달라는 말보다, 표로 세 줄만 정리해 달라고 해야 잘 맞는 답이 돌아옵니다.
5단계 · 환각 — 지어내기 (영상 2:38)
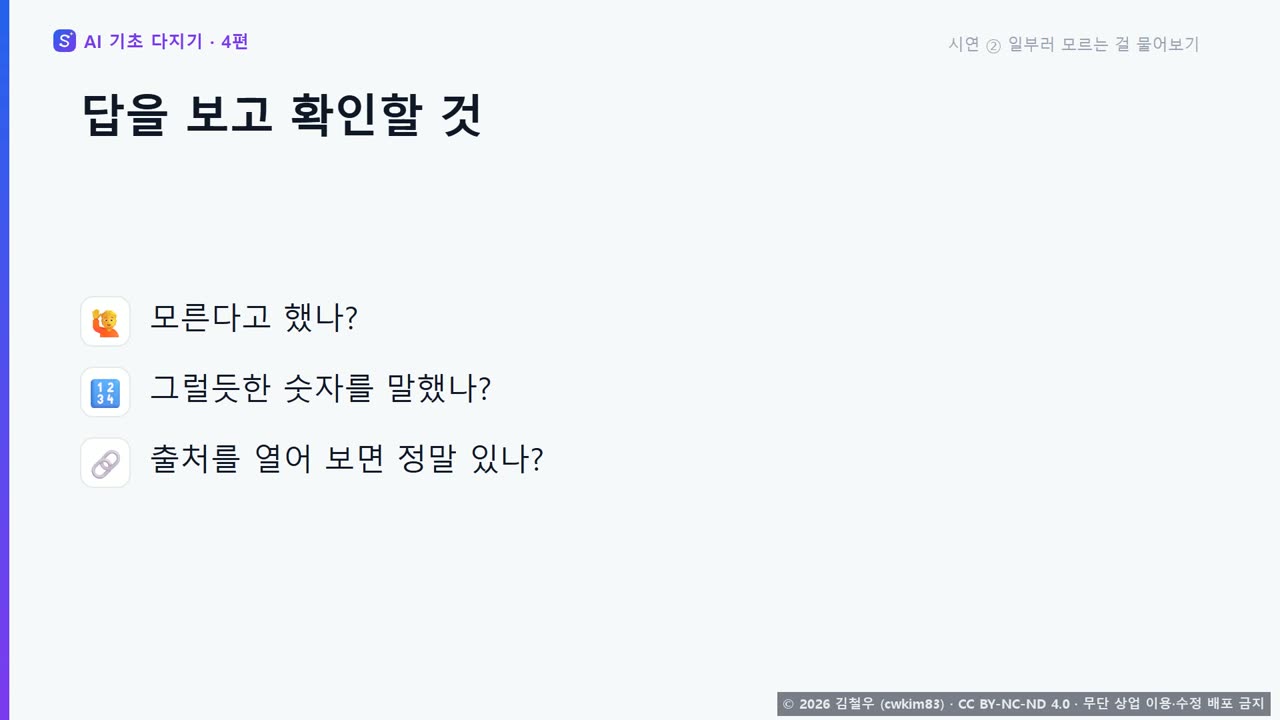
이제 가장 중요한 주의점입니다. AI는 모르는 것도 그럴듯하게 지어낼 수 있어요. 이것을 환각이라고 합니다. 다음 말을 맞히는 기계라서, 모른다고 멈추기보다 그럴듯한 말을 이어 가는 일이 있기 때문이에요. 숫자와 날짜, 사람 이름, 출처처럼 정확해야 하는 내용일수록 특히 조심해야 합니다. 해결책은 간단합니다. 중요한 내용은 반드시 원문이나 출처로 다시 확인하는 습관이에요.
6단계 · 사용 한도와 모델 고르기 (영상 3:07)
AI는 많이 쓸수록 계산할 일이 늘어납니다. 그래서 요금제마다 쓸 수 있는 양, 한도가 정해져 있어요. 큰 모델일수록, 그리고 대화가 길수록 한도를 더 빨리 씁니다. 그래서 산초 강좌에서는 Sonnet이 만들고, Opus는 마지막 검증에만 썼습니다. 쉬운 일은 가벼운 모델로, 어려운 일은 큰 모델로 나눠 쓰면 한도를 아낄 수 있어요.
7단계 · 시연 ① 같은 질문을 두 모델에게 (영상 3:31) 🎬
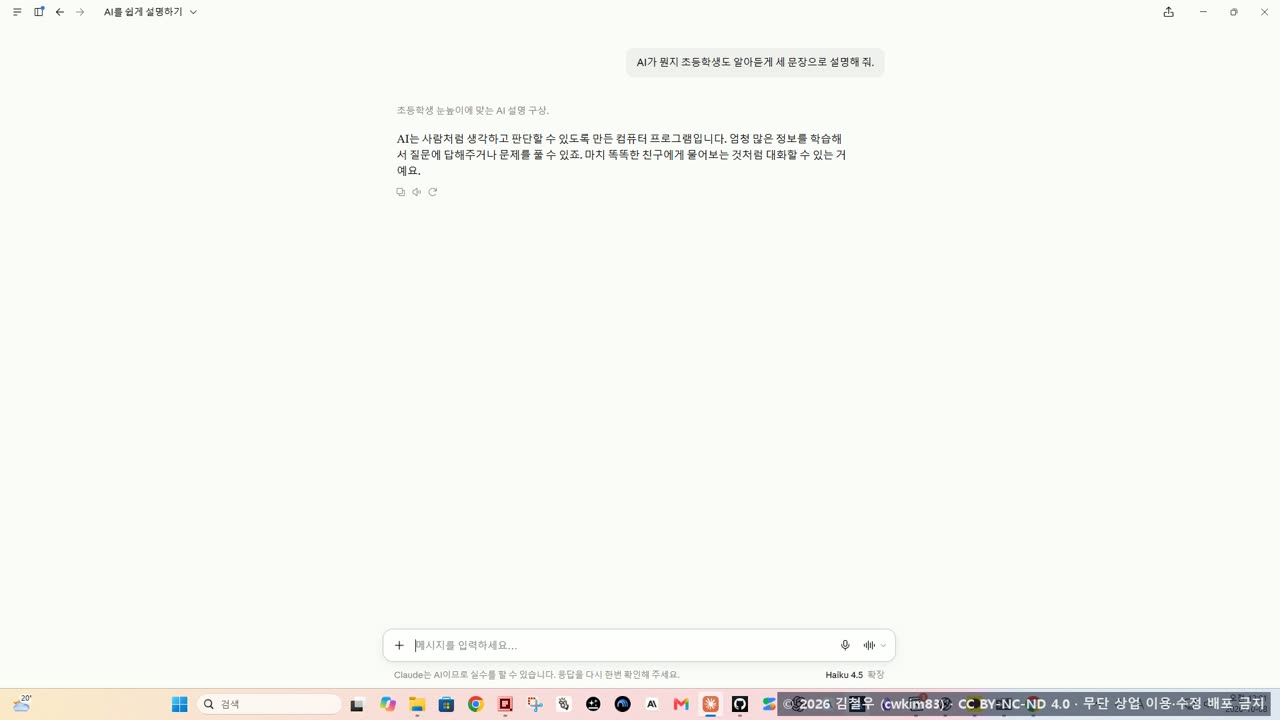
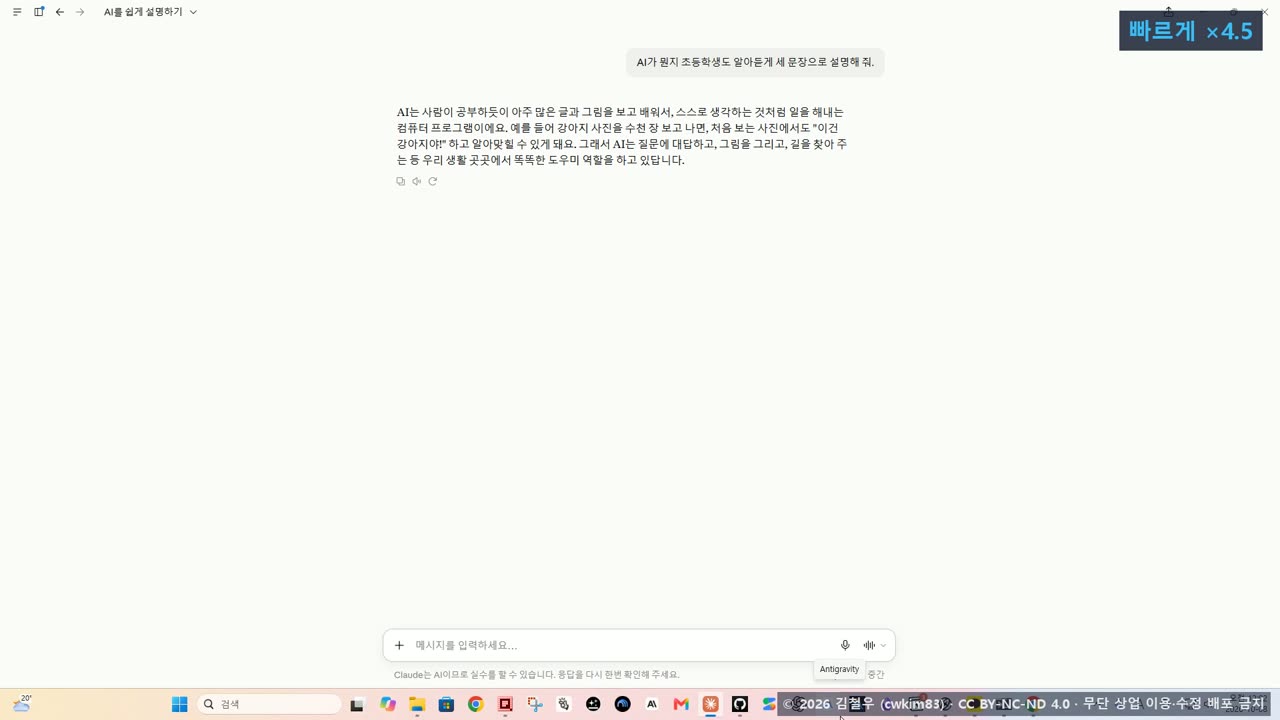
시연입니다. Claude 채팅에서 같은 질문을 두 모델에게 물어봅니다. 모델 목록을 열면 Fable, Opus, Sonnet, Haiku 가 보입니다. 맨 위 Fable 은 가장 어려운 과제용이에요. 먼저 가장 빠른 Haiku 에게, "AI가 뭔지 초등학생도 알아듣게 세 문장으로 설명해 줘" 라고 했어요. 답이 금방 나왔습니다. 짧고 깔끔하죠. 이번에는 새 대화에서 Opus 에게 같은 질문을 합니다. 강아지 사진 예를 들어 더 풍부하게 설명하네요. 쉬운 질문에서도 모델마다 결이 다릅니다.
8단계 · 시연 ② 일부러 모르는 걸 물어보기 (영상 4:10) 🎬
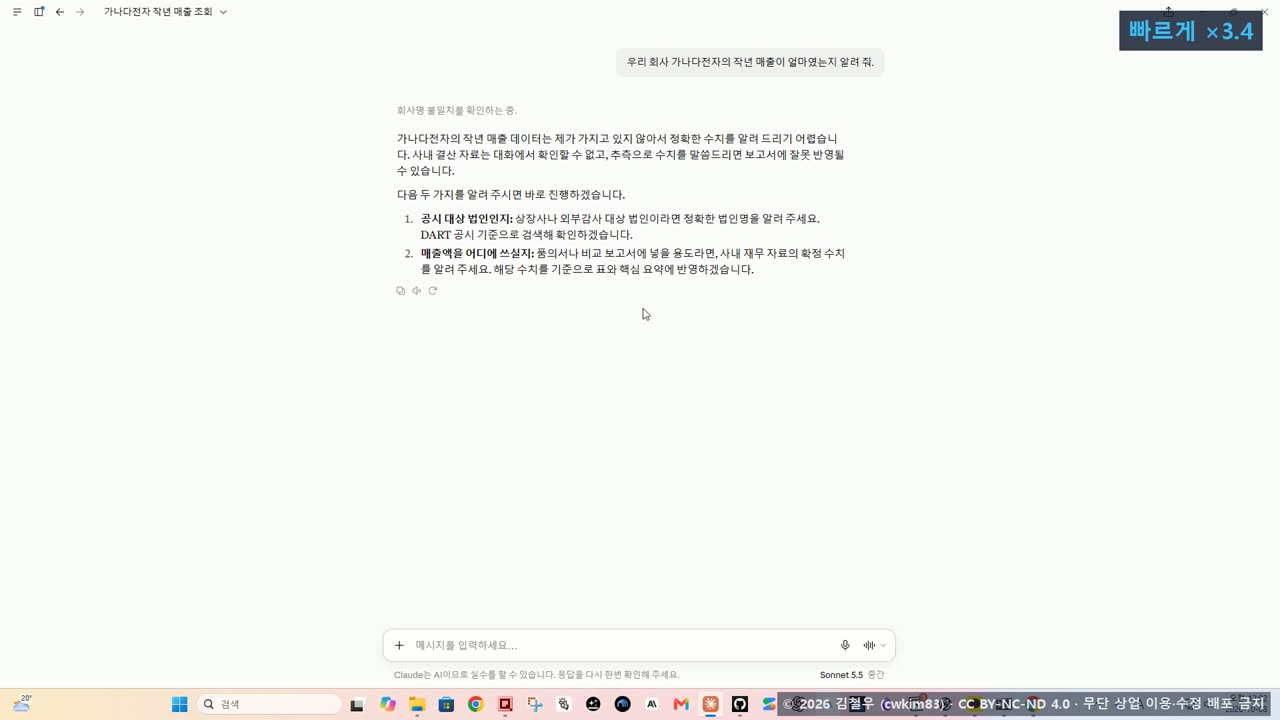
이번에는 일부러 모르는 것을 물어봅니다. 가상의 회사, 가나다전자의 작년 매출이에요. Sonnet 은 "자료가 없어서 정확한 수치를 알려 드리기 어렵다"고 답했습니다. 추측하면 보고서에 잘못 들어갈 수 있다고까지 말하죠. 하지만 AI 가 늘 이렇게 정직한 건 아닙니다. 그럴듯한 숫자를 말한다면 출처를 물어보세요. 출처가 흐릿하거나 열어 봐도 내용이 없다면, 그 숫자는 믿으면 안 됩니다. 확인하는 습관이, AI 를 안전하게 쓰는 첫걸음입니다.
9단계 · 정리 (영상 4:43)
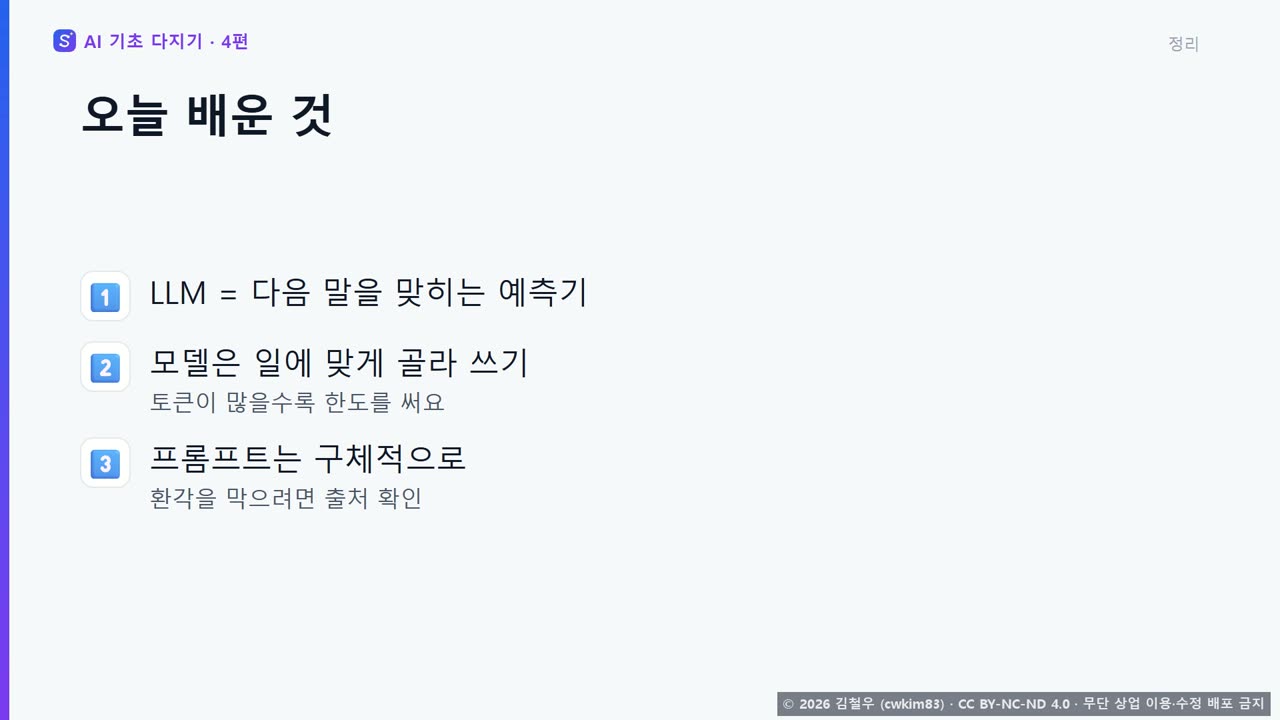
오늘 배운 것을 세 줄로 정리합니다. 하나, LLM은 다음 말을 맞히며 글을 이어 가는 예측기입니다. 둘, 모델은 크기와 성격이 달라서 일에 맞게 골라 쓰고, 토큰이 많을수록 한도를 씁니다. 셋, 프롬프트는 구체적으로 쓰고, 환각을 막으려면 중요한 내용의 출처를 확인합니다. 산초 1편의 장면 10, Opus 검증과 산초 2편의 장면 1, 새 세션이 오늘 내용과 이어집니다. 다음 5편에서는 인터넷 없이 내 컴퓨터에서 도는 AI, 로컬 LLM을 배웁니다. 감사합니다.
💡 이 편의 어려운 말
- 두뇌: 산초 강좌에서 비서가 생각하고 답하는 부분을 부른 말이에요. 산초의 두뇌는 내 PC 의 Claude Code 이고, 화면과 서버(몸통)와는 따로입니다.
- 모델 (model): AI 의 종류·등급 이름이에요. 같은 Claude 라도 모델에 따라 속도·꼼꼼함·사용량이 달라서 일에 맞게 바꿔 씁니다(예: Sonnet, Opus).
- 사용량(한도) (usage limit): Claude 를 쓰면 쓴 만큼 사용량이 쌓이고, 요금제마다 쓸 수 있는 한도가 정해져 있어요. 산초 강좌에서는 모델을 바꾸면 대화를 다시 읽느라 사용량을 더 쓴다는 경고가 뜹니다.
- 시스템 프롬프트 (system prompt): 대화가 시작되기 전에 AI 에게 미리 깔아 주는 기본 지침이에요. 산초는 이름·말투·'기억해' 규칙 같은 것을 이 지침에 적어 둡니다.
- 토큰 (token): 비밀번호처럼 '나임'을 증명하는 긴 문자열이에요(접속 토큰·봇 토큰). 대화창에 붙여 넣거나 남에게 보이면 안 됩니다. AI 쪽에서는 글을 잘게 나눈 단위를 뜻하기도 하며 사용량도 이 단위로 셉니다.
- 프롬프트 (prompt): AI 에게 보내는 글, 곧 '시킬 말'이에요. 산초 강좌에서는 '요청문'이라고 불렀고, 무엇을 왜 어디까지 만들지 분명히 적을수록 잘 만들어집니다.
- 환각(지어내기) (hallucination): AI 가 모르는 것을 모른다고 하지 않고 그럴듯하게 지어내는 일이에요. 숫자·출처·날짜처럼 중요한 것은 꼭 직접 확인해야 합니다.
- AI (Artificial Intelligence): 사람처럼 글을 읽고 쓰고 판단해 주는 컴퓨터 프로그램을 통틀어 부르는 말이에요(인공지능). 이 강좌에서는 Claude 같은 대화형 AI 를 가리킵니다.
- Haiku: Claude 모델 가족의 하나로 Opus·Sonnet 과 같은 시리즈 이름이에요. 일반적으로 가볍고 빠른 쪽을 가리킵니다(산초 강좌에는 나오지 않아요).
- LLM (Large Language Model): 아주 많은 글을 읽고 '다음에 올 말'을 맞히도록 훈련된 AI 모델이에요(거대 언어 모델). 산초 강좌에서는 이 부분을 '두뇌'라고 불렀습니다.
- Opus: Claude 모델 중 더 꼼꼼한 쪽이에요. 산초 강좌에서는 Sonnet 이 만든 결과를 Opus 가 검증하는 역할을 맡았습니다.
- Sonnet: Claude 모델 중 가볍고 빠른 쪽이에요. 산초 강좌에서는 Sonnet 5.5 가 코드를 만드는 일을 맡았습니다.
자주 막히는 곳
- AI 가 그럴듯한 숫자를 말하는데, 믿어도 되나요? → AI 는 모르는 것도 그럴듯하게 지어낼 수 있고, 이것을 환각이라고 합니다. 다음 말을 맞히는 기계라서 모른다고 멈추기보다 그럴듯한 말을 이어 가는 일이 있기 때문이에요. 숫자·날짜·사람 이름·출처일수록 조심하고, 출처를 물어봐서 흐릿하거나 열어 봐도 내용이 없다면 그 숫자는 믿으면 안 됩니다. 중요한 내용은 반드시 원문이나 출처로 다시 확인하세요.
- 대화가 길어지면 AI 가 앞부분을 잊은 것 같아요. → AI 가 한 번에 눈앞에 펼쳐 놓고 볼 수 있는 양에는 한계가 있고, 이 범위를 문맥이라고 합니다. 책상 크기와 같아서, 대화가 길어져 책상이 가득 차면 앞부분이 흐려져요. 산초 강좌에서 편마다 새 세션을 연 이유가 바로 이것입니다.
- 토큰이 두 가지 뜻으로 나와서 헷갈려요. → AI 가 글을 읽는 단위로서의 토큰은 레고 블록처럼 잘게 쪼갠 글의 조각입니다. 산초 4편과 9편에 나온 토큰은 비밀번호 같은 열쇠예요. 이름만 같은 다른 말이니 구별해서 읽으세요.
- 오퍼스·소넷·하이쿠 중에 무엇을 써야 하나요? 한도는 왜 빨리 닳나요? → Opus 는 크고 꼼꼼해서 어려운 일이나 검증에, Sonnet 은 빠르고 균형이 좋아 일상 작업에, Haiku 는 가볍고 아주 빠르지만 어려운 문제에서는 덜 꼼꼼할 수 있습니다. 큰 모델일수록, 그리고 대화가 길수록 한도를 더 빨리 쓰니, 쉬운 일은 가벼운 모델로 어려운 일은 큰 모델로 나눠 쓰면 한도를 아낄 수 있어요.
스스로 점검
- LLM 이 '다음에 올 말을 맞히는 거대한 예측기'라는 것을 휴대폰 자동완성에 빗대어 설명할 수 있다.
- 오퍼스·소넷·하이쿠가 크기와 성격이 다른 모델이라는 것을 말하고, 일에 맞게 나눠 쓰면 한도를 아낄 수 있는 이유를 설명할 수 있다.
- 토큰(글의 조각)과 문맥(한 번에 볼 수 있는 범위)이 무엇인지 말할 수 있다.
- 프롬프트를 무엇을 어떤 조건으로 어떤 모양으로 달라고, 구체적으로 쓰는 예를 들 수 있다.
- 환각이 무엇인지 설명하고, 숫자·날짜·사람 이름·출처는 원문이나 출처로 다시 확인해야 하는 이유를 말할 수 있다.
다음에 볼 것
- 다음 편: AI 기초 다지기 - 5편 내 PC 에서 도는 AI
- 강좌 처음 페이지: AI 기초 다지기 — 산초 강좌 전에 보는 10편